02 / Vision AI
직접 체험 ↗Watchers
영상에서 데이터로, 데이터에서 안전으로.
CONTEXT & CONTRIBUTION
프로젝트와 나의 역할
산업 현장 영상의 전처리·자동 라벨링·검수·학습을 연결한 Vision AI 프로젝트입니다.
영상 변환과 프레임 추출, YOLO·Grounding DINO 자동 라벨링, 클래스 통일·IoU 중복 제거, CVAT 검수 형식 생성, 데이터셋 병합과 학습·평가.
핵심 흐름
- 영상 → 프레임 → 라벨 초안 → 사람 검수 → 학습 파이프라인
- 검수 완료 데이터만 병합해 라벨 품질 관리
- 클래스별 탐지 결과와 평가 지표 비교
기여 범위와 검증 한계
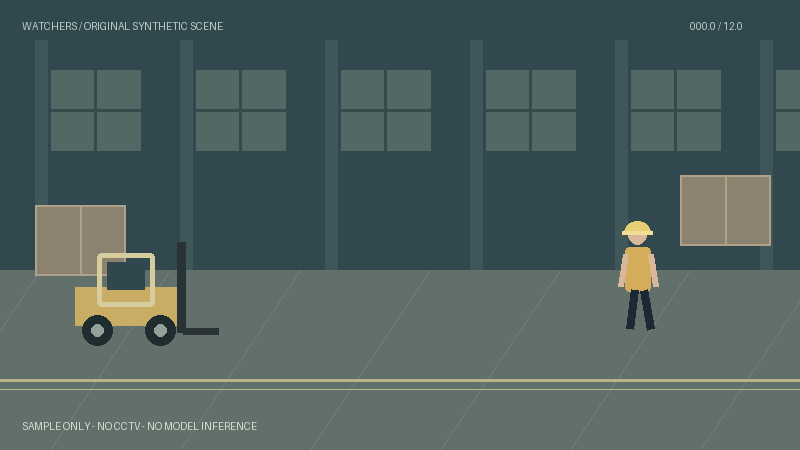
직접 체험 →이 포트폴리오의 영상은 직접 제작한 합성 장면입니다. 탐지 데이터도 장면에 맞춰 사전에 정의한 예시이며 YOLO의 실제 추론이나 원본 프로젝트 평가 결과가 아닙니다.